Executive Summary
Chi ha detto che l’architettura NVIDIA Pascal (rilasciata nel 2016) sia obsoleta per la moderna Intelligenza Artificiale Generativa?
Con un setup dual-GPU (GTX 1080 Ti 11GB + GTX 1070 8GB) per un totale di 19 GB di VRAM su bus PCIe 3.0, è possibile ottenere velocità di generazione sorprendenti senza investire migliaia di euro in nuovo silicio.
Il Problema: Il Muro di CUDA 12 & sm_61
I moderni binari precompilati di framework LLM (come Ollama standard o le release generiche di llama.cpp) tendono a dismettere o penalizzare il supporto per l’architettura Pascal (compute_61 / sm_61), privileged solo su Volta, Turing, Ampere o Ada Lovelace.
Inoltre, Pascal non possiede Tensor Cores dedicati FP16 o altri, rendendo le moltiplicazioni matriciali convenzionali lente se non ottimizzate ad hoc per il calcolo FP32, e nemmeno per quelli quantizzati INT4/INT8. Insomma… qualcosa dovevo fare!
La Soluzione
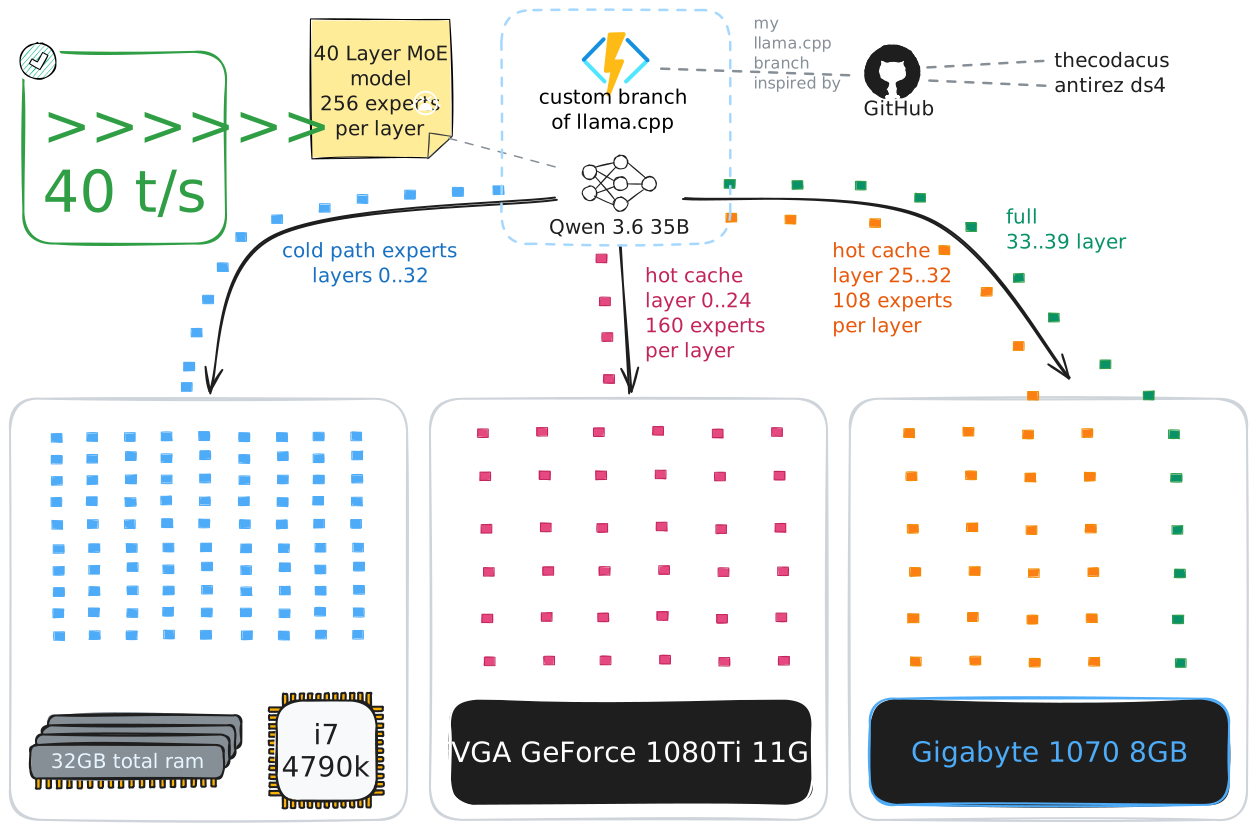
Ho preso spunto da un tizio su youtube, thecodacus https://www.youtube.com/watch?v=k_LostFpatg e sono partito dal suo branch qui llama.cpp, che faceva vedere come ottimizzava per sistemi con poca memoria, poi forte delle parole di antirez, ho detto ma sì, vediamo che succede…
Le modifiche che ho fatto al codice, grazie a Codex, sono state quelle di scegliere la distribuzione dei MoE sulle due schede invece che una sola e anche di quanti esperti per layer per ogni scheda.
Show off performance
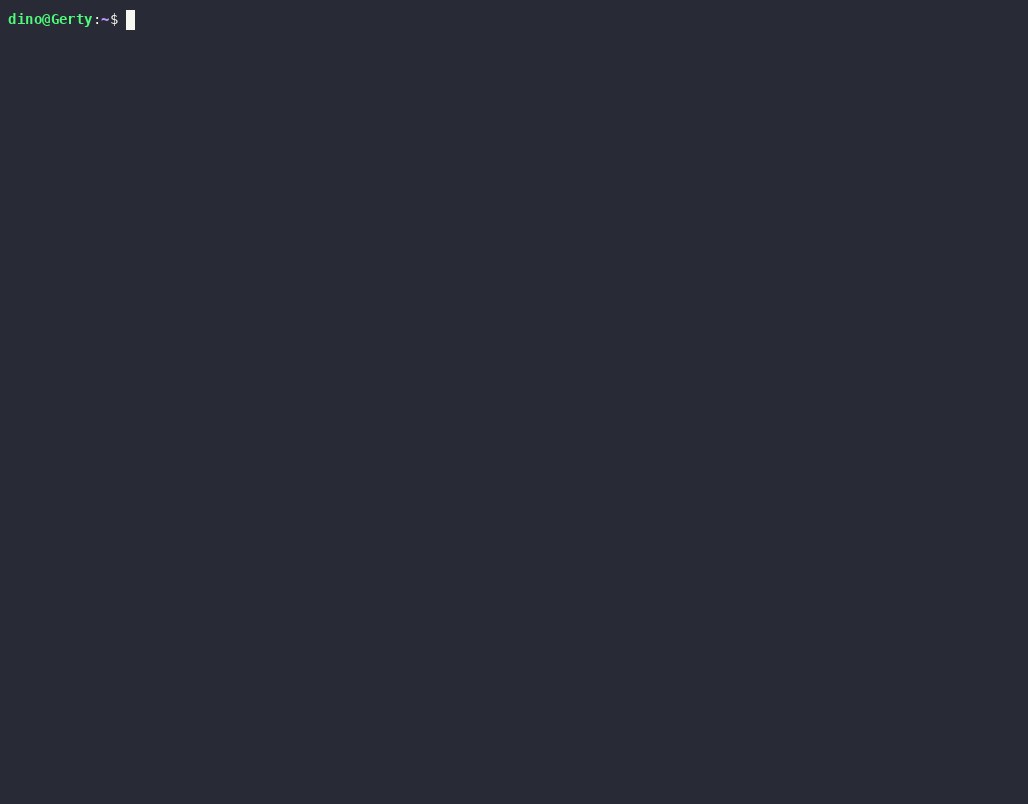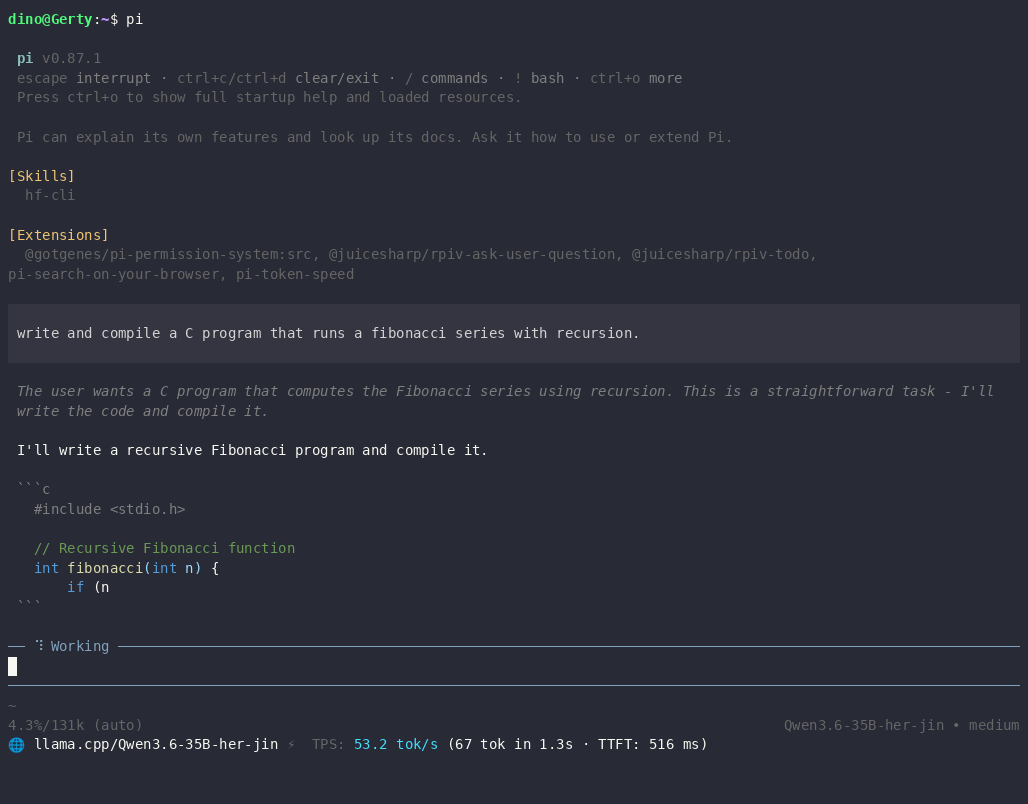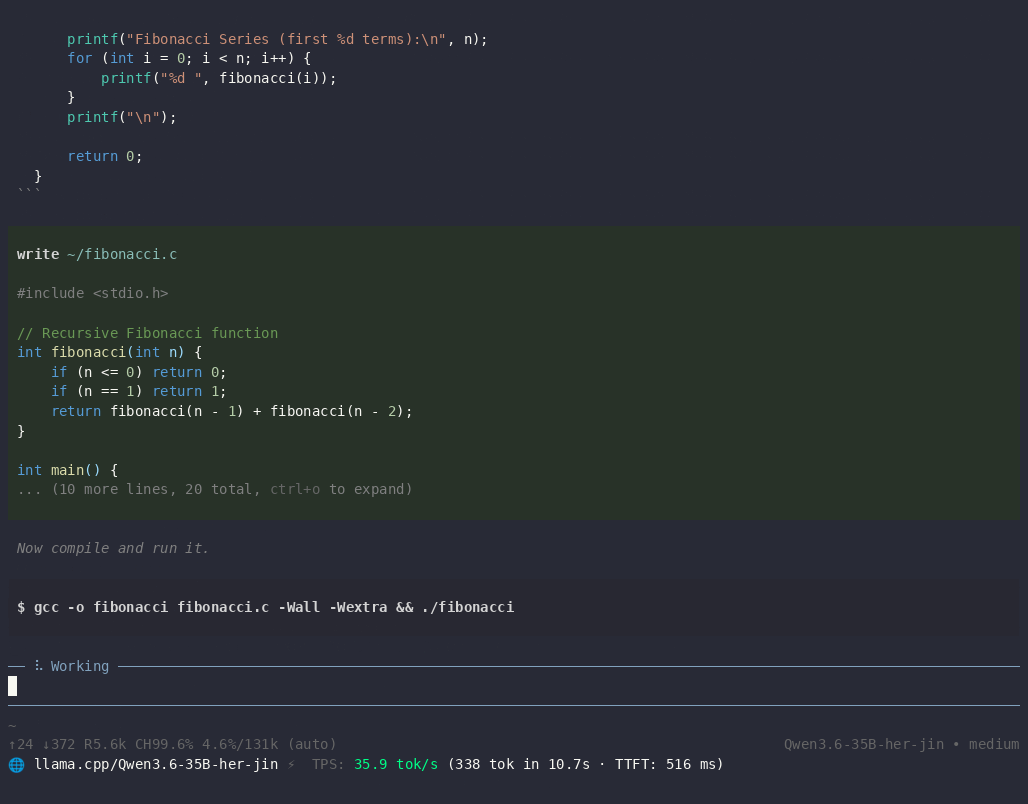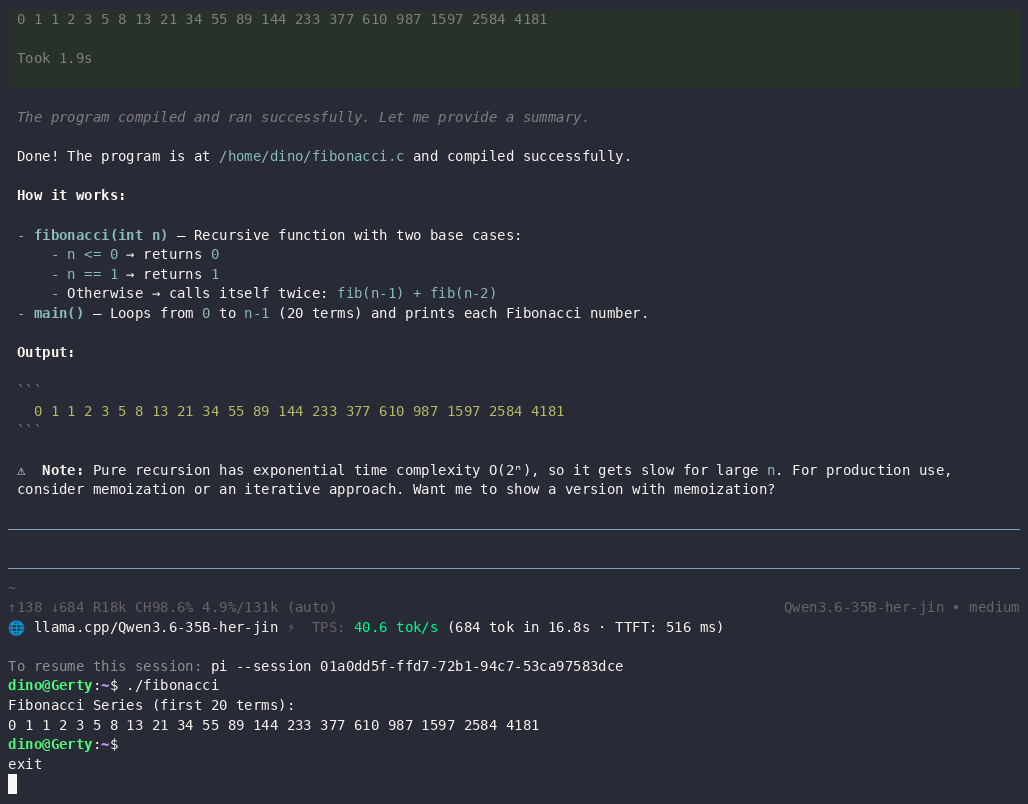
Cache MoE Distribuita su Dual GPU Pascal
L’implementazione upstream mantiene gli esperti più frequenti (hot) nella VRAM della GPU e quelli secondari (cold) nella RAM di sistema. Tuttavia, l’allocazione originaria piazzava tutti i pacchetti di cache su CUDA0 (GTX 1080 Ti), lasciando CUDA1 (GTX 1070) senza cache locale per il suo gruppo di layer e sprecando parte della sua VRAM (un collo di bottiglia critico data l’assenza di supporto CUDA P2P su schede Pascal consumer).
La patch in src/llama-model.cpp (init_moe_expert_cache()) vincola la cache alla GPU a cui è effettivamente assegnato ciascun layer (dev_layer[il]) e introduce quote asimmetriche per scheda, ad esempio con:
--moe-cache-slots 160,108 assegna 160 esperti hot per layer su CUDA0 e 108 su CUDA1, senza alterare logica di routing o pesi.
Flusso di Esecuzione a Doppio Binario
Per ogni layer MoE con cache attiva, il router separa le richieste tra VRAM e RAM di sistema, calcola i due percorsi in parallelo e ne combina l’output. I migliori risultati li ho ottenuti con questa configurazione
Ripartizione Fisica del Modello (-ncmoe 33, 40 Layer Totali)
| Dispositivo | Layer di Competenza | Residenza Esperti |
|---|---|---|
| CPU / RAM | Percorso cold per layer 0–32 | Pesi originali completi per layer 0–32 |
| CUDA0 · GTX 1080 Ti (11 GB) | Layer 0–24 | Hot cache (160 slot per layer) |
| CUDA1 · GTX 1070 (8 GB) | Layer 25–39 | Hot cache (108 slot per 25–32) + tutti gli esperti residenti per 33–39 |
Devo rifare questo diagramma, farlo più bello con excalidraw :D
flowchart TB
    %% Ingestion del Token e Routing
    subgraph INGRESSO ["🎯 Flusso di Inferenza"]
        TOKEN["Token al Layer MoE"] --> ROUTER{"Router del Layer"}
    end

    %% RAM di Sistema (Fallback Cold)
    subgraph HOST ["🖥️ Host System: CPU & RAM"]
        COLD_RAM["🧊 Pesi 'Cold' (Layer 0–32)<br/>Esperti non in cache residenti in RAM"]
    end

    %% GPU 0
    subgraph GPU0 ["🟢 CUDA0: NVIDIA GTX 1080 Ti (11 GB)"]
        direction TB
        L0_24["📦 Layer 0–24"]
        HOT0["🔥 Hot Cache VRAM<br/>160 slot esperti per layer"]
        L0_24 --- HOT0
    end

    %% GPU 1
    subgraph GPU1 ["🔵 CUDA1: NVIDIA GTX 1070 (8 GB)"]
        direction TB
        L25_32["📦 Layer 25–32 (Ibridi)"]
        HOT1["🔥 Hot Cache VRAM<br/>108 slot esperti per layer"]
        L33_39["💎 Layer 33–39 (Completi)"]
        RES1["⚡ 100% Esperti Residenti<br/>Tutti i pesi in VRAM (zero fallback)"]

        L25_32 --- HOT1
        L33_39 --- RES1
    end

    %% Smistamento del Router
    ROUTER -->|"Layer 0–24: Esperti HOT"| HOT0
    ROUTER -->|"Layer 0–24: Esperti COLD"| COLD_RAM

    ROUTER -->|"Layer 25–32: Esperti HOT"| HOT1
    ROUTER -->|"Layer 25–32: Esperti COLD"| COLD_RAM

    ROUTER -->|"Layer 33–39: Sempre residenti"| RES1

    %% Combinazione Output
    HOT0 --> OUTPUT["⚖️ Combinatore Output Layer"]
    COLD_RAM --> OUTPUT
    HOT1 --> OUTPUT
    RES1 --> OUTPUT
Il Risultato
Risolta l’allocazione asimmetrica della VRAM senza dipendere dal bus P2P, la cooperazione tra le due schede diventa finalmente bilanciata. La combinazione tra questa cache distribuita, la residenza ibrida e il modello di decoding speculativo (MTP) ha consentito di raggiungere velocità di inferenza fluide anche su hardware di generazione 2016.
Conclusioni & Filosofia
Hardware apparentemente datato può offrire prestazioni eccezionali quando il software viene adattato all’architettura fisica invece di affidarsi a build generiche. Mi è piaciuto assai lavorare a questo progetto!